马上注册,下载更多AI资源软件
您需要 登录 才可以下载或查看,没有账号?立即注册
×
Wan2GP V51版:优化UI及多个模型更新 低配显卡玩转AI绘画/视频生成/音乐语音生成 ... ...
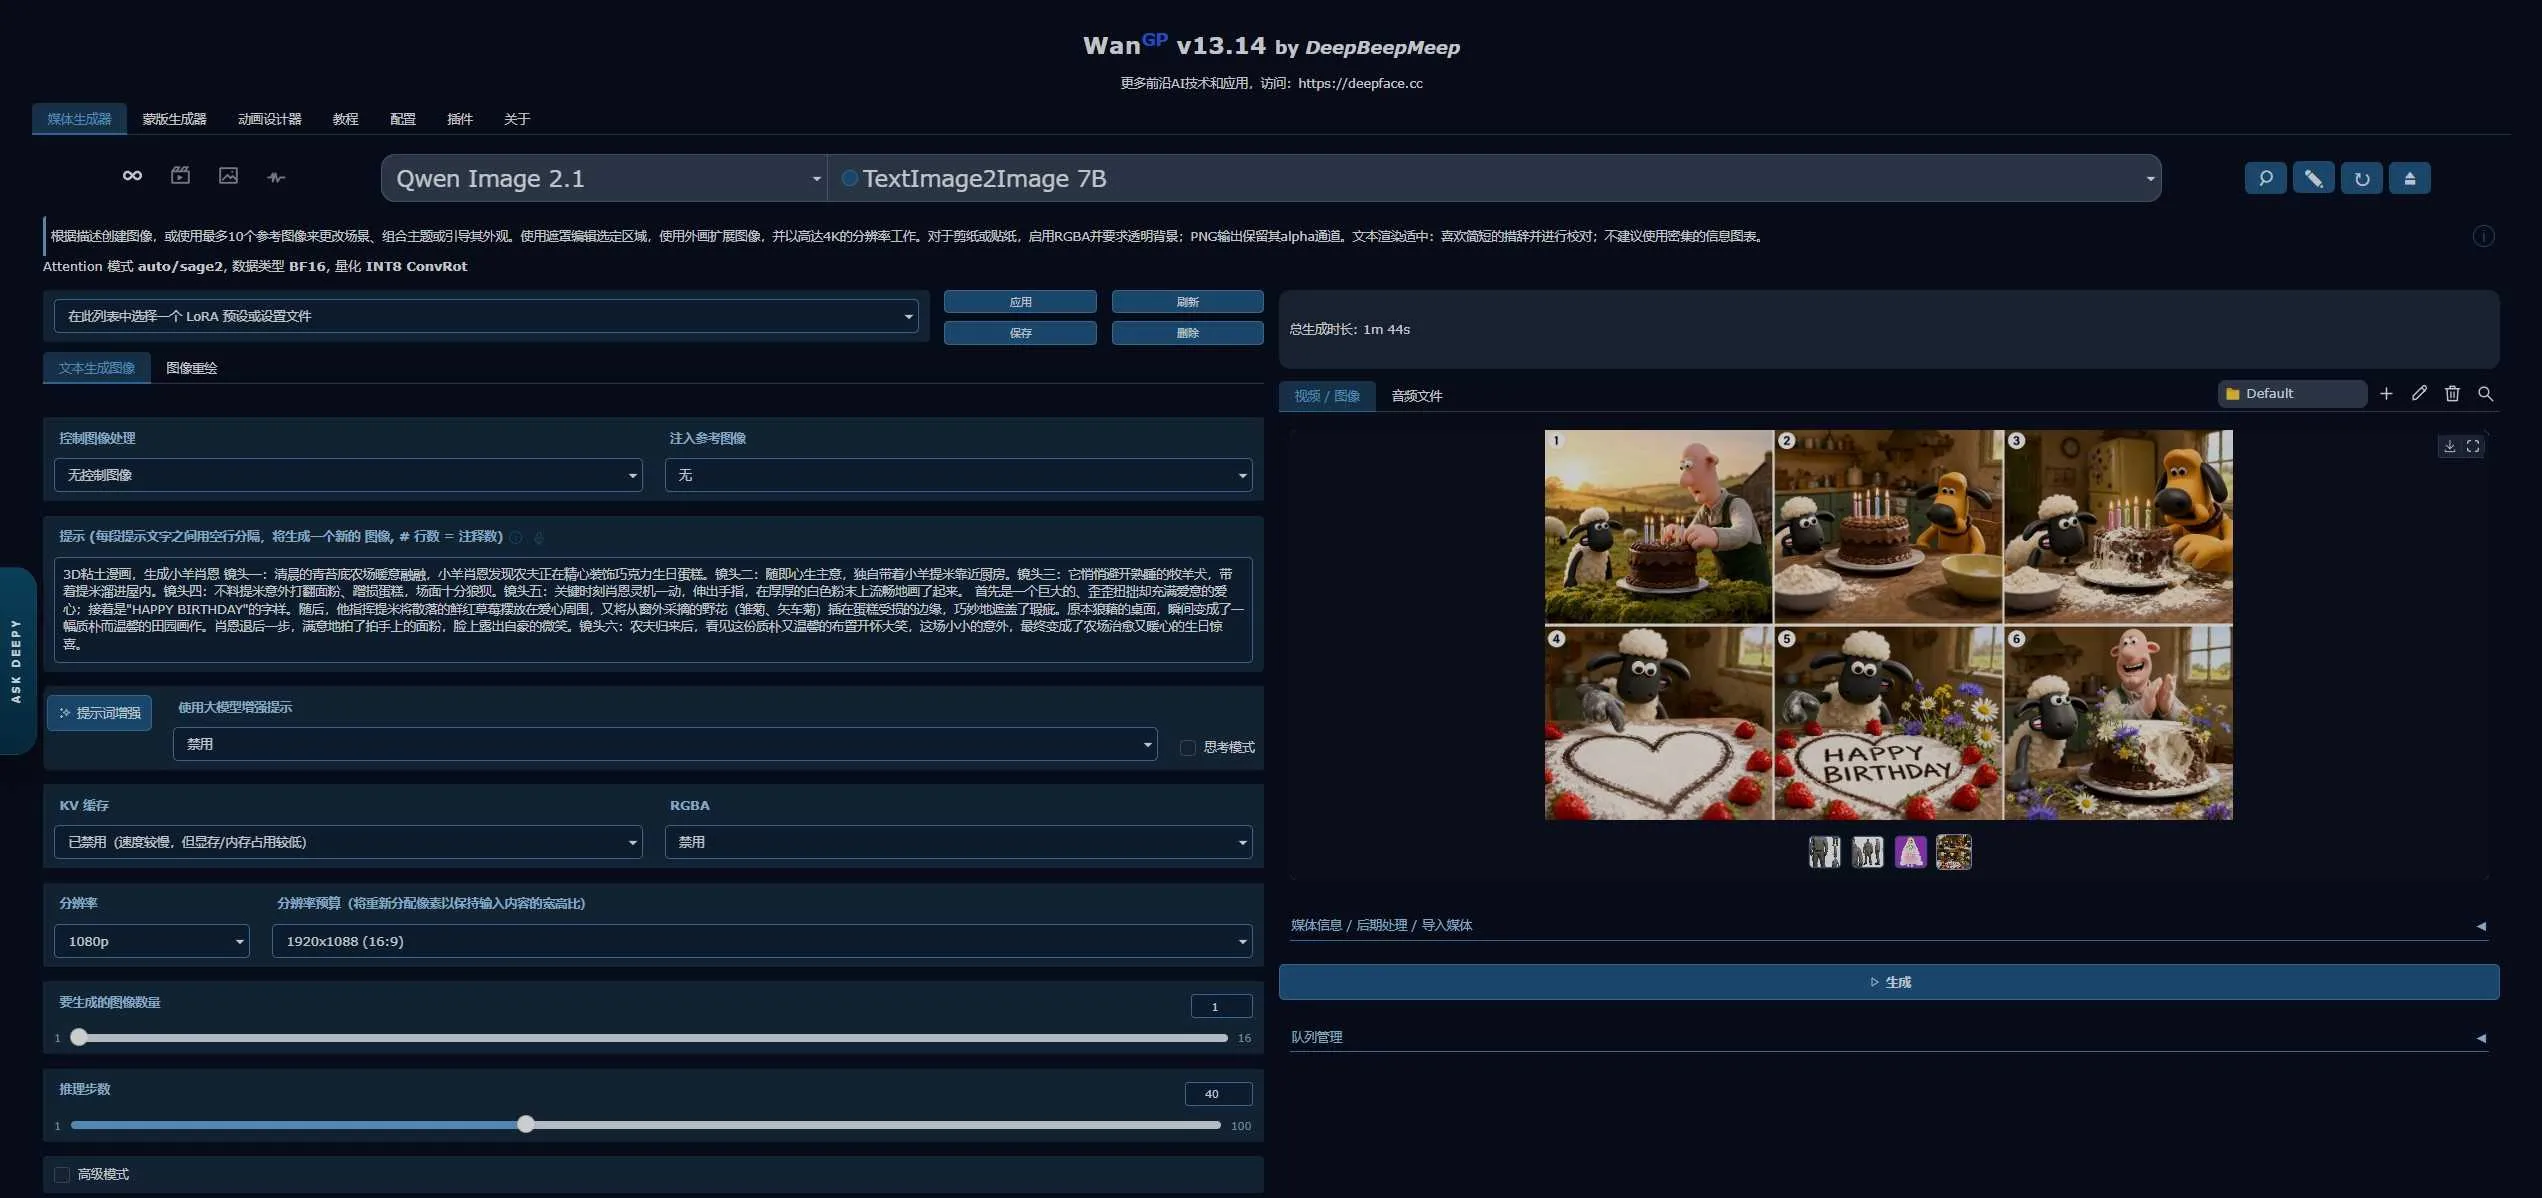
Wan2GP 是一个由DeepBeepMeep开发开源的 “显卡门槛低的全能型 AI 创作工具”,最大的特点是“低显存也能跑”,支持多种模型(视频、图像、语音、音乐),旨在为GPU资源有限的用户提供高质量的 视频/绘画 生成体验。它囊括了多种绘画/视频生成模型,包括最新的MiniMax H3、阿里的Wan及其衍生模型、腾讯的Hunyuan Video和LTV Video等主流视频生成和Qwen-Image-Edit、Flux、Z-Image等模型,通过简洁易用的网页界面,用户无需深入了解复杂的模型细节,即可轻松生成想要的 绘画/视频内容。
Wan2GP 的问世,让广大低端显卡用户也能玩转高大上的视频生成项目了。就以当下最火的视频生成模型 MiniMax-H3来说,原版需要至少50G显存才能跑得动的模型,现在 Wan2GP 把这个标准降低到8GB,而且生成的视频质量几乎没用任何的损失和降低。但缺点也是有的,生成时间会拉长,同时需要更大的运行内存。
Wan2GP 同时支持各种主流高质量的AI绘画和图像编辑模型以及语音和音乐生成模型,目前支持Wan2、MiniMax H3和Hunyuan Vidoe等视频生成模型;Flux、Krea和Qwen主流图像生成和图像编辑模型;Qwen-TTS和Index-TTS等主流语音模型;YuE2ce-Step等音乐生成模型,涵盖视频生成、图像生成、语音音乐等综合领域All In One。
今天分享的 Wan2GP V51版,基于官方 9月28日的 V13.14 打包。新增 Qwen Image 2.1、Ming Image 0.1、YuE2、AuK Speech 与 Viggle Animate,并强化 H3、LTX2.5 与 Krea 2 能力,以及新增实时预览、工作区、多设备同步、Deepy遮罩与混流、FLAC与去人声,并优化UI、进度取消与加速内核。
因后期版本整体做了模块化及大量内部重构,翻译的工作量难度也相应增大,翻译后的版本可能有一些问题, 如有影响使用的问题,请评论区回复,会第一时间修复。
在尽量保证功能完整的情况下,进一步对WebUI做了更多的汉化翻译,目前汉化率97%。新增“多开”功能,支持一次开启多个WebUI。
注. 从V6版到V39版,提供两种版本,免费版和付费版。区别为:免费版不再提供中文翻译,原汁原味官方原版,不包含模型;付费版为中文翻译版,包含一些常用的模型,后期会逐步加入更多模型,以及一些优化功能加入。
因个人精力优先,故从V40版起,不再发布任何免费版本的Wan2GP一键包。如需免费版,请移步历史版本。
9月28日更新内容
环境部分:
更新GGUF内核,优化Wan Pytorch 编译器,恢复稳定的环境 torch到2.7;更新 SageAttention;集成Git环境,无需手动安装Git即可实现插件安装配置
因官方已支持 Python 3.11、Pytorch 2.10、Cuda 13组合,对Blackwell架构显卡做了大量优化和性能提升,后期版本考虑单独制作一个基于Blackwell架构(50系显卡)版的Wan2GP。
主要更新内容:
模型更新
Qwen Image 2.1:新的 Qwen Image 模型,具有开箱即用的编辑功能和强大的文本渲染功能。
仅Yue2乐器模型:您现在只能生成乐器曲目,请检查主下拉框中的新选项以及提示说明或新的提示增强器模板。
Yue2 Hum to Song:将清晰的哼唱旋律、您的歌词和音乐风格变成一首新的立体声歌曲。
Ming Image 0.1 Design:一种新的图像生成和编辑模型,用于详细的信息图表、海报和精心布置的布局。它接受标准文本提示和结构化 JSON 格式,以便更精确地控制合成。 WanGP 的可视化提示助手可让您排列图层并编辑它们的位置、颜色和描述。您还可以选择经典或 JSON 提示增强器,将简短的提示转变为具有明确标题、标签和解释的详细提示。
Ming Image 0.1 Design-Layer:将完成的海报、信息图或其他设计转换为单独的透明图像层。提供一张参考图像和从前到后描述各层的文本提示。 WanGP 将每个 RGBA 图层添加到图像库并保存完整图层集的 ZIP。设计和设计层共享其语言编码器和视觉塔检查点,以减少下载和磁盘使用。
AuK 语音:根据书面指令生成语音,或使用源录音进行语音克隆、口语编辑、语音清理和说话人分离。选择 Flash 以获得快速的四步结果,或选择 Base 以获得更多控制。从一个短片开始,描述要更改的内容和要保留的内容。
Viggle Animate:基于 H3 的模型,类似于 Wan Animate,但只有 3 个步骤。为 Viggle 提供一个控制视频和一个编辑帧(从控制视频获取的一帧中注入要制作动画的人或对象,使用 WanGP 图像编辑器或询问 Deepy)。运动效果相当好,但模型需要构建 5 秒长的滑动窗口。
功能更新包含不限于以下:
实时视频预览:观看生成过程中的运动发展!在“配置”/“常规”/“生成预览”下,选择传统的快速 RGB 帧、更清晰的 Tiny VAE 帧或循环的 Tiny VAE 视频。单击视频可暂停/恢复。谢谢@GOvEy1nw!
YuE2 乐谱延续:“作曲源”菜单可让您导入或扩展 ABC 乐谱,包括从音频转录的乐谱。谢谢@Beanow!
H3 欢迎更多参考:Ref2VA 现在可接受最多三个参考视频和三个音频参考以及图像参考。参考视频共享 15 秒预算;音频参考共享单独的 15 秒预算。
Krea 2 Real 和 HD VAE:Krea 2 和兼容的 Qwen Image 20B/Edit 型号获得 VAE 下拉菜单:尝试使用 Real 来获取照片纹理,尝试使用 HD 来获取细节和对比度。
Deepy 学习魔法蒙版:要求 Deepy 蒙版图像或视频中的命名对象、反转选择或创建简单的矩形蒙版。蒙版直接进入图库进行编辑。
更快的深度和即时增强:GGUF CUDA 内核 1.0.25 加速了 Q4_K 和 Bonsai PTQ1_0 的推测解码,无需额外的 VRAM。
Comfy Kitchen 内核支持:这些内核会自动安装,可以加速特定模型。它们已集成到 H3 和 LTX2.x 中,现在速度提高了 10%。
Minimax H3 INT8 ConvRot VAE:速度提高一倍。现在,当在变压器配置中选择 INT8 时,会自动下载并默认使用。
UI 优化:UI 应该更快,尤其是图像/视频库。
DLSS 5 神经渲染 — 不仅仅是高档:为完成的图像和视频提供 AI 修饰,可以丰富光照和材质外观,改善皮肤、头发、织物和树叶等精细特征,并随着时间的推移保持增强效果的稳定。使用 x1 进行原始分辨率细化,或使用 x1.5–x3 进行细化和放大,并可调节强度。 WanGP 估计录制媒体的深度和运动,因此结果仍然依赖于内容。请参阅 DLSS 5 概述和安装指南。
项目特点
低显存要求:只需 6GB 显存即可运行部分模型,适合“显卡贫民”(老款 NVIDIA RTX 10xx/20xx)。
多模型支持:兼容 Wan 2.1/2.2、Hunyuan Video、Flux、Qwen Image、LTX Video、Kandinsky 等主流开源生成模型。
多模态功能:不仅能生成视频,还支持图像编辑、语音合成(TTS)、音乐生成。
插件生态:内置画廊浏览器、模型管理器、CivitAI 下载器、Upscaler 等工具,方便扩展。
易用性:提供完整的网页界面和命令行模式,支持队列生成和批处理。
优化性能:支持量化(int8、fp8、NV FP4 等),提升速度同时降低显存占用。
应用领域
短视频创作:快速生成 AI 视频,用于社交媒体内容、广告或创意展示。
语音合成与配音:支持情感化 TTS,可生成多角色对话,适合播客、虚拟主播。
音乐生成:内置 Ace Step、Heart Mula 等模型,可自动生成歌曲和歌词。
学术研究与实验:为研究人员提供多模态生成平台,方便测试不同模型。
个性化创作:支持 Lora 微调和控制视频生成参数,满足定制化需求。
使用教程:(建议N卡,显存6G起,部分模型需内存32G起。支持50系显卡,基于CUDA12.8)
使用和之前发布的Wan2.1以及类似的视频生成软件类似,根据需要,点击最上方的模型列表,切换需要使用的模型,会根据切换的模型自动下载,模型较大,耐心等待下载完成。
注. 模型是通用的,更新新版后,只需要将之前旧版的模型目录(目录下的ckpts)移动到新软件目录下即可,无需重复下载
支持文生视频和图生视频。支持低端显卡运行阿里Wan、腾讯HunyuanVideo以及LTV Video等高精度模型。支持多种Lora类型扩展,请根据页面使用说明将lora模型放入对应的目录手动加载。
启动WebUI后,页面有“指南”选项卡,作者很详细的介绍了不同的模型参数和特点及应用领域、Lora模型的加载及使用以及VACE ControlNet的详细使用说明。UI我也做了大部分汉化,方便大家使用。
基于原版使用文档,我做了详细的翻译,建议大家仔细阅读,作为操作参考。
测试了30-50系显卡,均能正常运行。10-20没做测试,可自行测试
模型下载技巧:打开模型下载链接后,选择“按修改时间”排序,即可快速找到最新版本同步更新的模型,下载放到ckpts目录即可。
Wan2.2 提示词填写技巧,可以参考官方文档:
https://mp.weixin.qq.com/s/ucHuyomTZ6X2q_tL3wHQQg
https://alidocs.dingtalk.com/i/nodes/jb9Y4gmKWrx9eo4dCql9LlbYJGXn6lpz
软件目录结构:
📂 ckpts/
│ ├── 📂 chinese-wav2vec2-base/
│ │ └── pytorch_model.bin
│ ├── 📂 Qwen2.5-VL-7B-Instruct/
│ │ └── Qwen2.5-VL-7B-Instruct_quanto_bf16_int8.safetensors
│ └── 📂 umt5-xxl/
│ └── models_t5_umt5-xxl-enc-quanto_int8.safetensors
📂 models/
│ ├── 📂 qwen/
│ ├── 📂 wan/
│ ...
📂 loras/
📂 deepface/
......
下载地址:
夸克网盘:
🔒付费内容 游客, 上上宾会员 可免费下载该资源, 点此开通上上宾 免费下载全站99%的付费资源。或单独支付 99碎银 下载该资源
百度网盘:
🔒付费内容 游客, 上上宾会员 可免费下载该资源, 点此开通上上宾 免费下载全站99%的付费资源。或单独支付 99碎银 下载该资源
| 


 发表于
 发表于