马上注册,下载更多AI资源软件
您需要 登录 才可以下载或查看,没有账号?立即注册
×
Wan2GP V52版:全面加速生态,显存更低,速度更快!低配显卡玩转AI绘画/视频生成/音乐语音生成 ...
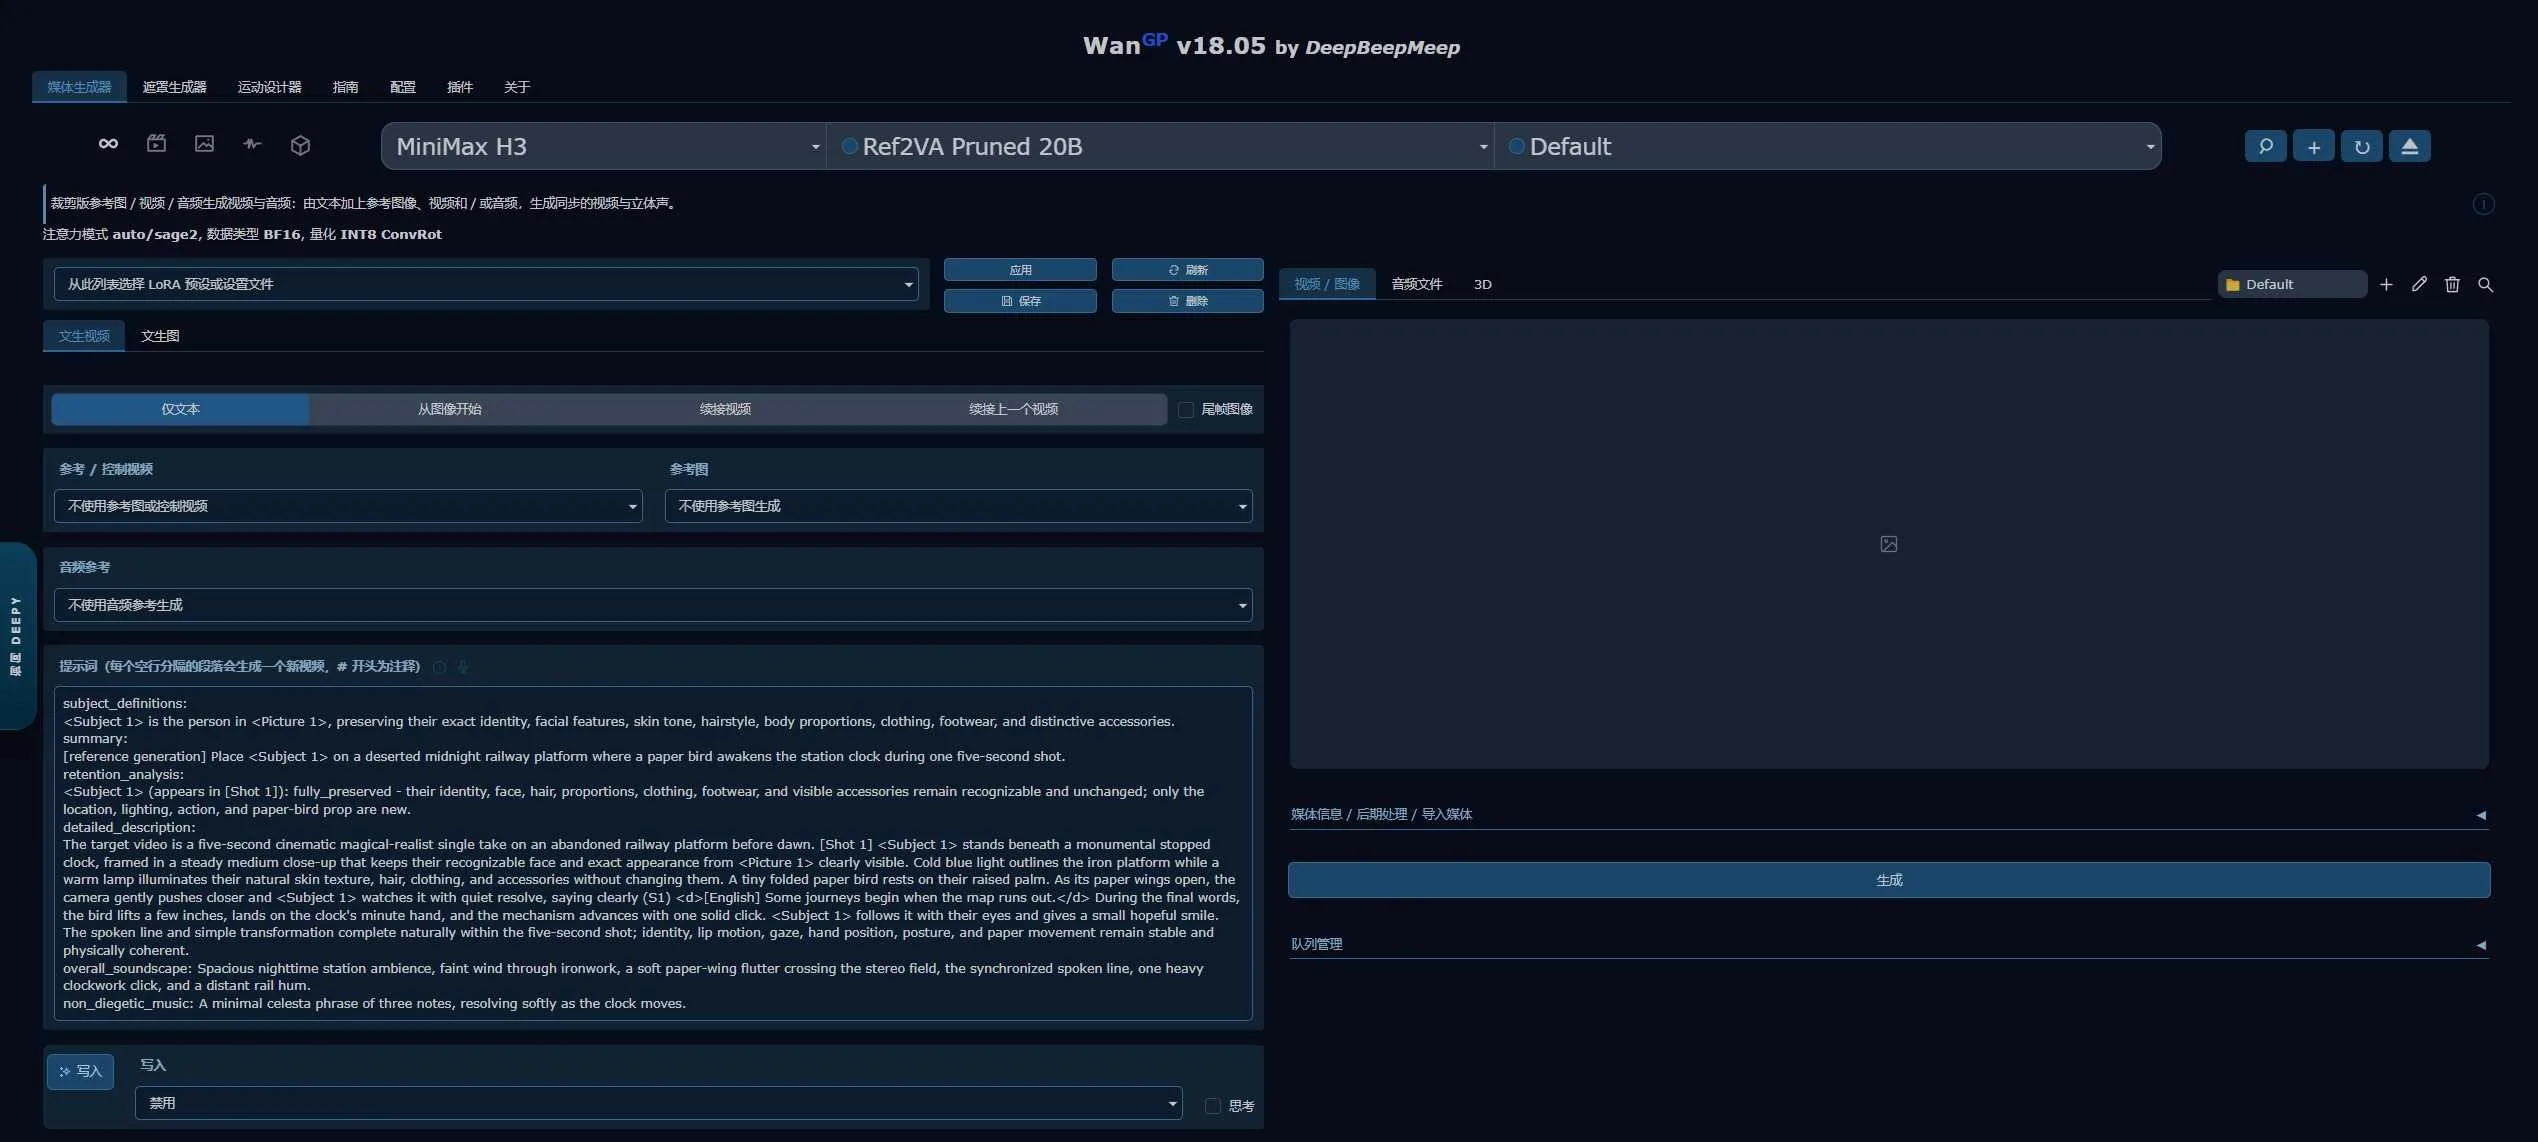
Wan2GP 是一个由DeepBeepMeep开发开源的 “显卡门槛低的全能型 AI 创作工具”,最大的特点是“低显存也能跑”,支持多种模型(视频、图像、语音、音乐),旨在为GPU资源有限的用户提供高质量的 视频/绘画 生成体验。它囊括了多种绘画/视频生成模型,包括最新的MiniMax H3、阿里的Wan及其衍生模型、腾讯的Hunyuan Video和LTV Video等主流视频生成和Qwen-Image-Edit、Flux、Z-Image等模型,通过简洁易用的网页界面,用户无需深入了解复杂的模型细节,即可轻松生成想要的 绘画/视频内容。
Wan2GP 的问世,让广大低端显卡用户也能玩转高大上的视频生成项目了。就以当下最火的视频生成模型 MiniMax-H3来说,原版需要至少50G显存才能跑得动的模型,现在 Wan2GP 把这个标准降低到8GB,而且生成的视频质量几乎没用任何的损失和降低。但缺点也是有的,生成时间会拉长,同时需要更大的运行内存。
Wan2GP 同时支持各种主流高质量的AI绘画和图像编辑模型以及语音和音乐生成模型,目前支持Wan2、MiniMax H3和Hunyuan Vidoe等视频生成模型;Flux、Krea和Qwen主流图像生成和图像编辑模型;Qwen-TTS和Index-TTS等主流语音模型;YuE2ce-Step等音乐生成模型,涵盖视频生成、图像生成、语音音乐等综合领域All In One。
今天分享的 Wan2GP V52版,基于官方 10月11日的 V18 打包。升级 MMGP v4 显存管理系统,大幅降低模型运行显存占用,并优化 Profile 4/5 速度,实现低显存显卡更快运行大型视频模型。进一步扩展生态,重构 VAE 加速体系,提升 Wan、LTX、Hunyuan 等模型生成效率,同时新增视频、3D、Agent 等工作流支持,使 WanGP 从低显存视频生成工具升级为综合 AI 创作平台。
因后期版本整体做了模块化及大量内部重构,翻译的工作量难度也相应增大,翻译后的版本可能有一些问题, 如有影响使用的问题,请评论区回复,会第一时间修复。
在尽量保证功能完整的情况下,进一步对WebUI做了更多的汉化翻译,目前汉化率97%。新增“多开”功能,支持一次开启多个WebUI。
注. 从V6版到V39版,提供两种版本,免费版和付费版。区别为:免费版不再提供中文翻译,原汁原味官方原版,不包含模型;付费版为中文翻译版,包含一些常用的模型,后期会逐步加入更多模型,以及一些优化功能加入。
因个人精力优先,故从V40版起,不再发布任何免费版本的Wan2GP一键包。如需免费版,请移步历史版本。
10月14日更新内容
环境部分:
更新Python 3.11 + Pytorch 2.10 + Cuda 13组合环境;针对Blackwell架构显卡(比如50系显卡)做了大量优化改进,使其在各领域尤其是视频生成领域性能大幅度提升;集成Git环境,无需手动安装Git即可实现插件安装配置
内容更新:
更新MMGP v4,15 秒 1080p 的 H3 视频过去需要 25 GB 的 VRAM,现在只需要 11 GB 的 VRAM。每个人都是赢家,只需 5-6GB 的 VRAM 即可生成 15 秒的 480p H3 视频。生成大型视频时,Profile 4 的速度提高了 25%,并且使用的 VRAM 减少了 50%。除此之外,WanGP 还进行了优化,成为低 VRAM 应用程序的首选。更好的是:在许多情况下,Profile 4 现在击败了旧的 Profile 1,并与新的 Profile 1 相匹配。良好的旧式故障保护 Profile 5 速度提高了 50%。甚至安全网也得到了涡轮增压。(为了充分利用此更新,首先确保您使用 Sage2/2+ Attention,因为很多优化都依赖于它。然后打开新的 配置 → RAM/VRAM 管理选项卡,在 VRAM 分配器 下选择 MMGP 优化VRAM分配器 选项,然后打开 智能内存固定。如果更改分配器,请重新启动 WanGP。)
LTX 2.x VAE 速度提高 3 倍:LTX 2 VAE 在 WanGP 中进行了重写:使用 Profile 4 在 RTX 5090 上生成 20 秒的 480p (24fps) 视频现在大约需要 28 秒。实时,我们可以从这里看到您...
Wan 和 HunyuanVideo VAE 速度提高了 2 倍到 3.5 倍:我不想让这两个感到被抛弃。 Wan 2.1 VAE 速度提高了 3.5 倍(Wan 2.2 提高了 1.6 倍),并且需要更少的 VRAM:解码 1080p 从 28 秒/10.5 GB 到 11 秒/4.7 GB。 HunyuanVideo 的解码速度大约快 2 倍。这三者的优点是:平铺接缝在 Wan 上已成为历史(平铺 = 未平铺),而在 LTX 2 和 HunyuanVideo 上则更加微弱。
Kandinsky 6.0:具有同步音频(口型同步的语音、音乐、音效)的新视频生成器,Pro 30B 和 Lite 3B,两者均经过精炼。目前剪辑很短(5 秒),但 WanGP 版本的 VRAM 和往常一样低,并且其 VAE 比官方版本快 2 倍。
Wan 2.2 Prism Video:图像到音频的视频,源自Wan 2.2架构,原生最高2K。
CUDA 图形加速:消除让 GPU 等待的 CPU 时间。在较轻的 GPU 工作(图像模型)和中等 CPU 上大多可见:SenseNova +30%,Qwen Image 2.1 +10%,H3 约为 0%。
RTX 50xx 上的启动速度更快,SSD 更快乐:在 Blackwell GPU 上,NVIDIA 驱动程序会在每次启动时再次优化 GPU 代码,并将结果保存在共享的 1 GB 缓存中,该缓存太小而无法容纳所有内容:每个第一代都会丢失 10-15 秒,并且每次都会在 SSD 上重写缓存。勾选“配置”→“性能”→“WanGP 计算缓存”,为 WanGP 提供自己的缓存(最多 2 GB):工作一劳永逸。
3D Gen 模型:WanGP 进入三维,与其他模型具有大量协同作用:在新的 3D 查看器中旋转 3D 资源,以您想要的分辨率捕捉视图并将其用作起始图像,或者将生成的图像和视频转换为 3D。
H3 Veda Sparse:MiniMax H3 获得了学习稀疏注意力,高分辨率或更长视频的生成速度提高了 2 倍。适用于完整的 33B 和修剪的 20B FL2VA/Ref2VA 型号,使用相同的设置和 LoRA。
工作区文件夹:将每个项目生成和导入的媒体保存在自己的文件夹中,以便于组织和备份。为新工作区选择专用文件夹,或使用图库管理器转换现有工作区或选择不同的存储文件夹。要启用此功能:“配置/输出”选项卡。
扩展了对代理的 MCP 支持:外部代理获得新工具来验证生成设置、管理自己的工作区、检查图像、视频和 3D 资产以及传输文件。现在,代理活动在 Gradio 界面中可见,因此您可以跟踪他们的工作。
项目特点
低显存要求:只需 6GB 显存即可运行部分模型,适合“显卡贫民”(老款 NVIDIA RTX 10xx/20xx)。
多模型支持:兼容 Wan 2.1/2.2、Hunyuan Video、Flux、Qwen Image、LTX Video、Kandinsky 等主流开源生成模型。
多模态功能:不仅能生成视频,还支持图像编辑、语音合成(TTS)、音乐生成。
插件生态:内置画廊浏览器、模型管理器、CivitAI 下载器、Upscaler 等工具,方便扩展。
易用性:提供完整的网页界面和命令行模式,支持队列生成和批处理。
优化性能:支持量化(int8、fp8、NV FP4 等),提升速度同时降低显存占用。
应用领域
短视频创作:快速生成 AI 视频,用于社交媒体内容、广告或创意展示。
语音合成与配音:支持情感化 TTS,可生成多角色对话,适合播客、虚拟主播。
音乐生成:内置 Ace Step、Heart Mula 等模型,可自动生成歌曲和歌词。
学术研究与实验:为研究人员提供多模态生成平台,方便测试不同模型。
个性化创作:支持 Lora 微调和控制视频生成参数,满足定制化需求。
使用教程:(建议N卡,显存6G起,部分模型需内存32G起。支持50系显卡,基于CUDA12.8)
使用和之前发布的Wan2.1以及类似的视频生成软件类似,根据需要,点击最上方的模型列表,切换需要使用的模型,会根据切换的模型自动下载,模型较大,耐心等待下载完成。
注. 模型是通用的,更新新版后,只需要将之前旧版的模型目录(目录下的ckpts)移动到新软件目录下即可,无需重复下载
支持文生视频和图生视频。支持低端显卡运行阿里Wan、腾讯HunyuanVideo以及LTV Video等高精度模型。支持多种Lora类型扩展,请根据页面使用说明将lora模型放入对应的目录手动加载。
启动WebUI后,页面有“指南”选项卡,作者很详细的介绍了不同的模型参数和特点及应用领域、Lora模型的加载及使用以及VACE ControlNet的详细使用说明。UI我也做了大部分汉化,方便大家使用。
基于原版使用文档,我做了详细的翻译,建议大家仔细阅读,作为操作参考。
测试了30-50系显卡,均能正常运行。10-20没做测试,可自行测试
模型下载技巧:打开模型下载链接后,选择“按修改时间”排序,即可快速找到最新版本同步更新的模型,下载放到ckpts目录即可。
Wan2.2 提示词填写技巧,可以参考官方文档:
https://mp.weixin.qq.com/s/ucHuyomTZ6X2q_tL3wHQQg
https://alidocs.dingtalk.com/i/nodes/jb9Y4gmKWrx9eo4dCql9LlbYJGXn6lpz
软件目录结构:
📂 ckpts/
│ ├── 📂 chinese-wav2vec2-base/
│ │ └── pytorch_model.bin
│ ├── 📂 Qwen2.5-VL-7B-Instruct/
│ │ └── Qwen2.5-VL-7B-Instruct_quanto_bf16_int8.safetensors
│ └── 📂 umt5-xxl/
│ └── models_t5_umt5-xxl-enc-quanto_int8.safetensors
📂 models/
│ ├── 📂 qwen/
│ ├── 📂 wan/
│ ...
📂 loras/
📂 deepface/
......
下载地址:
一键包在路上...
| 


 发表于