马上注册,下载更多AI资源软件
您需要 登录 才可以下载或查看,没有账号?立即注册
×
Unlimited-OCR-2:百页千页文档一次解析,超长合同、整本书都能一次搞定,不再卡顿 ... ... ...
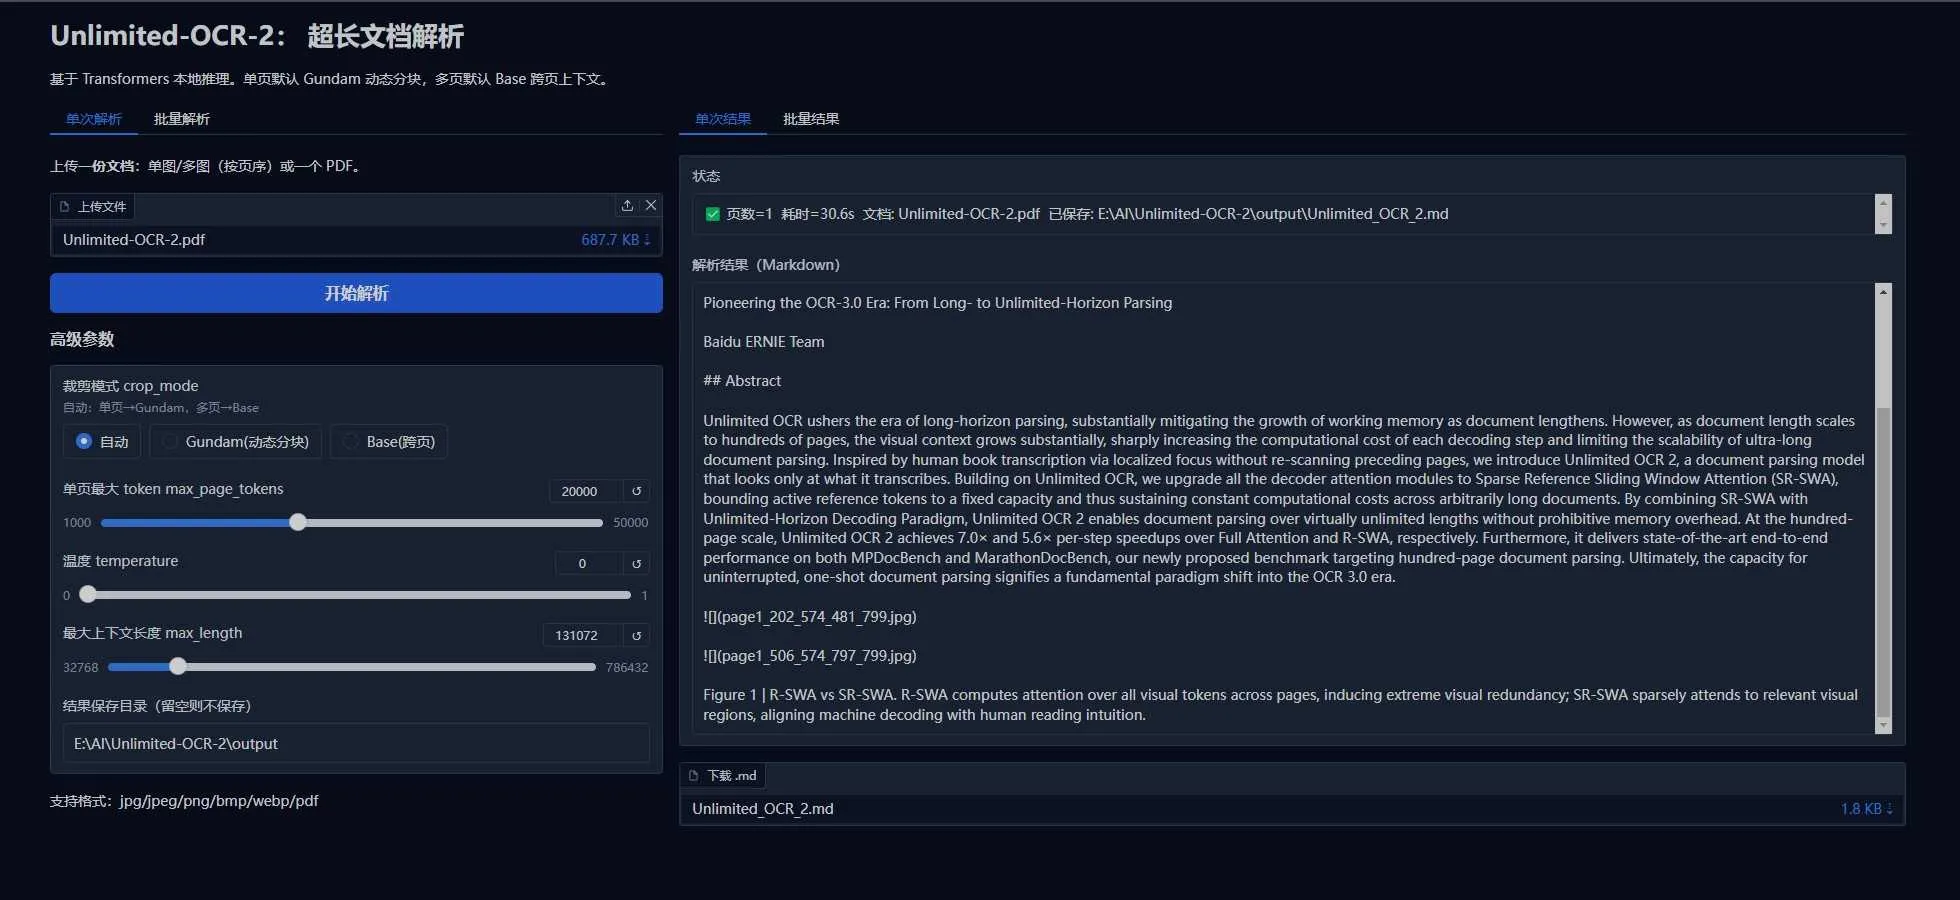
Unlimited-OCR-2 是百度开源的多模态 OCR 模型(约 3B 参数,MIT 许可证),专门解决“超长文档一次性完整解析”的问题。它号称开启了 OCR 3.0 时代,从“能处理长文档”升级到“几乎不限页数”。简单说,它把以前“页数一多就卡死”的 OCR 痛点基本解决了,特别适合真正意义上的长文档端到端解析。
主要特点
普通 OCR 或视觉语言模型在处理几十上百页文档时,会因为注意力机制计算量爆炸(二次方增长),导致显存爆、速度变慢、效果下降。
Unlimited-OCR-2 的关键技术是 SR-SWA(Sparse Reference Sliding Window Attention,稀疏参考滑动窗口注意力):
把超长文档的视觉-文本注意力,压缩成固定大小的“工作参考集”(例如只保留 512 个关键 token)。
就像人读书时只重点看当前页,偶尔回头翻以前相关页一样,而不是同时盯着整本书的每一页。
结果是:无论文档有多长(几十页、上百页甚至上千页),每一步的计算延迟和显存占用几乎保持稳定,不会随页数暴增。
其他亮点:
支持多页一次性输入(跨页理解上下文,输出时按页组织)。
在 MPDocBench(多页文档)和 MarathonDocBench(百页级超长文档)上达到当前最优(SOTA)表现。
实测能一次性处理整套《哈利·波特》系列(累计超 3600 页)这类极端长文档,并保持较高精度。
应用领域
超长合同、法律卷宗、招股书、财报:一次解析整份文件,保留跨页逻辑和结构。
书籍、历史档案、古籍数字化:整本书或整批档案直接转成可搜索、可编辑的文本。
企业知识库与文档智能:把海量扫描件、PDF 转成结构化数据,方便检索和问答。
教育、出版、科研:教材、论文集、研究报告的批量高精度 OCR。
任何需要“整本理解”而不是“逐页割裂”的场景。
使用教程:(建议N卡,显存8G起,支持50系显卡)
包含主程序压缩包和模型文件(models文件夹),分别下载,解压主程序后,将模型文件移动到主程序目录下即可
上传需要解析的文档(支持图像和pdf格式),点击解析即可
支持批量
下载地址:
光鸭云盘:https://www.guangyapan.com/s/1962469202502705195_afKpfuS_zVounNhq
夸克网盘:
| 


 发表于