马上注册,下载更多AI资源软件
您需要 登录 才可以下载或查看,没有账号?立即注册
×
LongCat-Video-Avatar-1.6:一张照片和一段语音,稳稳生成超 10 分钟超长不崩脸的真人感数字人视频 ... ... ...
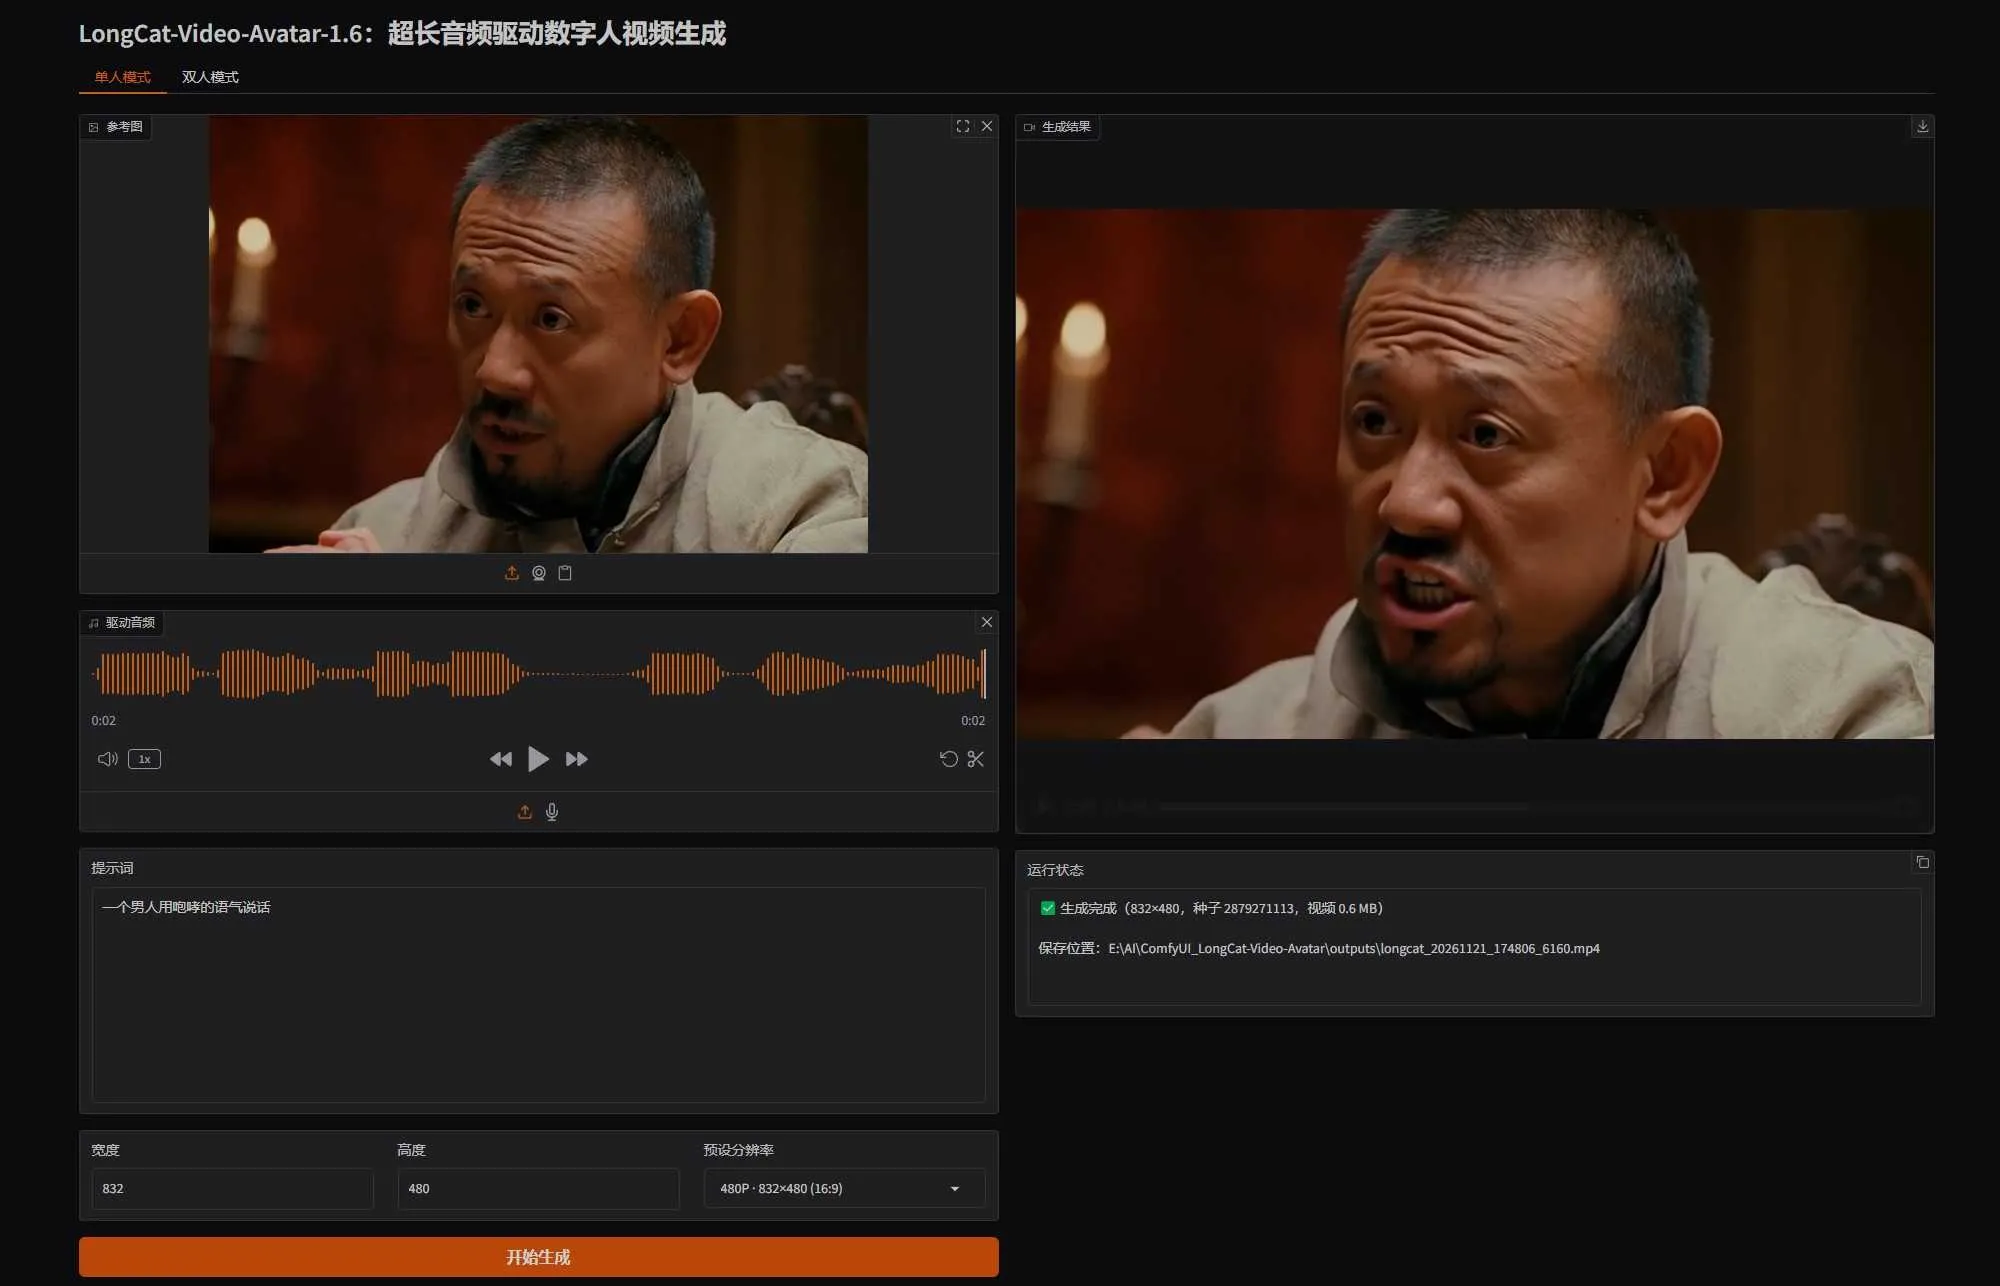
LongCat-Video-Avatar-1.6 是美团 LongCat 团队开源的一款音频驱动数字人视频生成模型。简单来说,你只要给它一段语音,再搭配一张人物照片或一段文字描述,它就能让画面中的人物“开口说话”,生成口型同步、表情和动作自然的数字人视频。
LongCat-Video-Avatar-1.6:一张照片和一段语音,稳稳生成超 10 分钟超长不崩脸的真人感数字人视频 ... ... ...
过去很多数字人模型只能做几秒到几十秒的短片段,时间一长就容易出现“换脸”“五官变形”或动作僵硬;而 1.6 版本的一大亮点,是能稳定生成超过 10 分钟的长视频。
核心特点
超长视频不容易“崩脸”:通过视频续写与减少长序列误差累积的机制,让人物在长达 10 分钟以上的讲话过程中,依然保持面部特征稳定、前后连贯。
口型与神态更自然:针对语音驱动优化了嘴部开合、唇音同步以及面部表情和肢体动作,整体表现更贴近真人说话,而不是机械对口型。
多输入组合灵活:支持结合音频、文本和图像生成视频(例如“音频+文字+图片”驱动),方便创作者控制人物外貌、场景氛围和表达细节。
生成速度更快、部署更友好:采用少步蒸馏(如 8 步生成路径)和量化权重(如 INT8)等优化方案,降低了推理耗时与硬件门槛,也更容易接入 ComfyUI 等常见工作流,并以较宽松的 MIT 协议开源权重。
应用领域
口播与自媒体创作:快速把配音或文案变成口播视频,适合知识科普、新闻播报、故事讲述和个人频道日常更新,无需每次都真人出镜拍摄。
在线教育与企业培训:将课程讲解音频或培训讲稿转化为稳定的讲师讲解视频,方便长课时制作和后续按需修改内容。
品牌营销与多语言本地化:结合不同语种的配音生成对应口型的宣传或讲解视频,降低跨区域内容制作与重复拍摄成本。
虚拟角色与互动陪伴:为虚拟主播、游戏/动漫角色或数字助手赋予更自然的语音表现力,提升角色陪伴与交互体验。
使用教程:(建议N卡,显存8G起,支持50系显卡)
下载主程序和模型(ComfyUI文件夹),解压主程序一键包,将ComfyUI文件夹移动到主程序目录下即可
WebUI
启动WebUI,上传参考图和驱动音频,输入提示词,设置宽度和高度,最后生成即可。
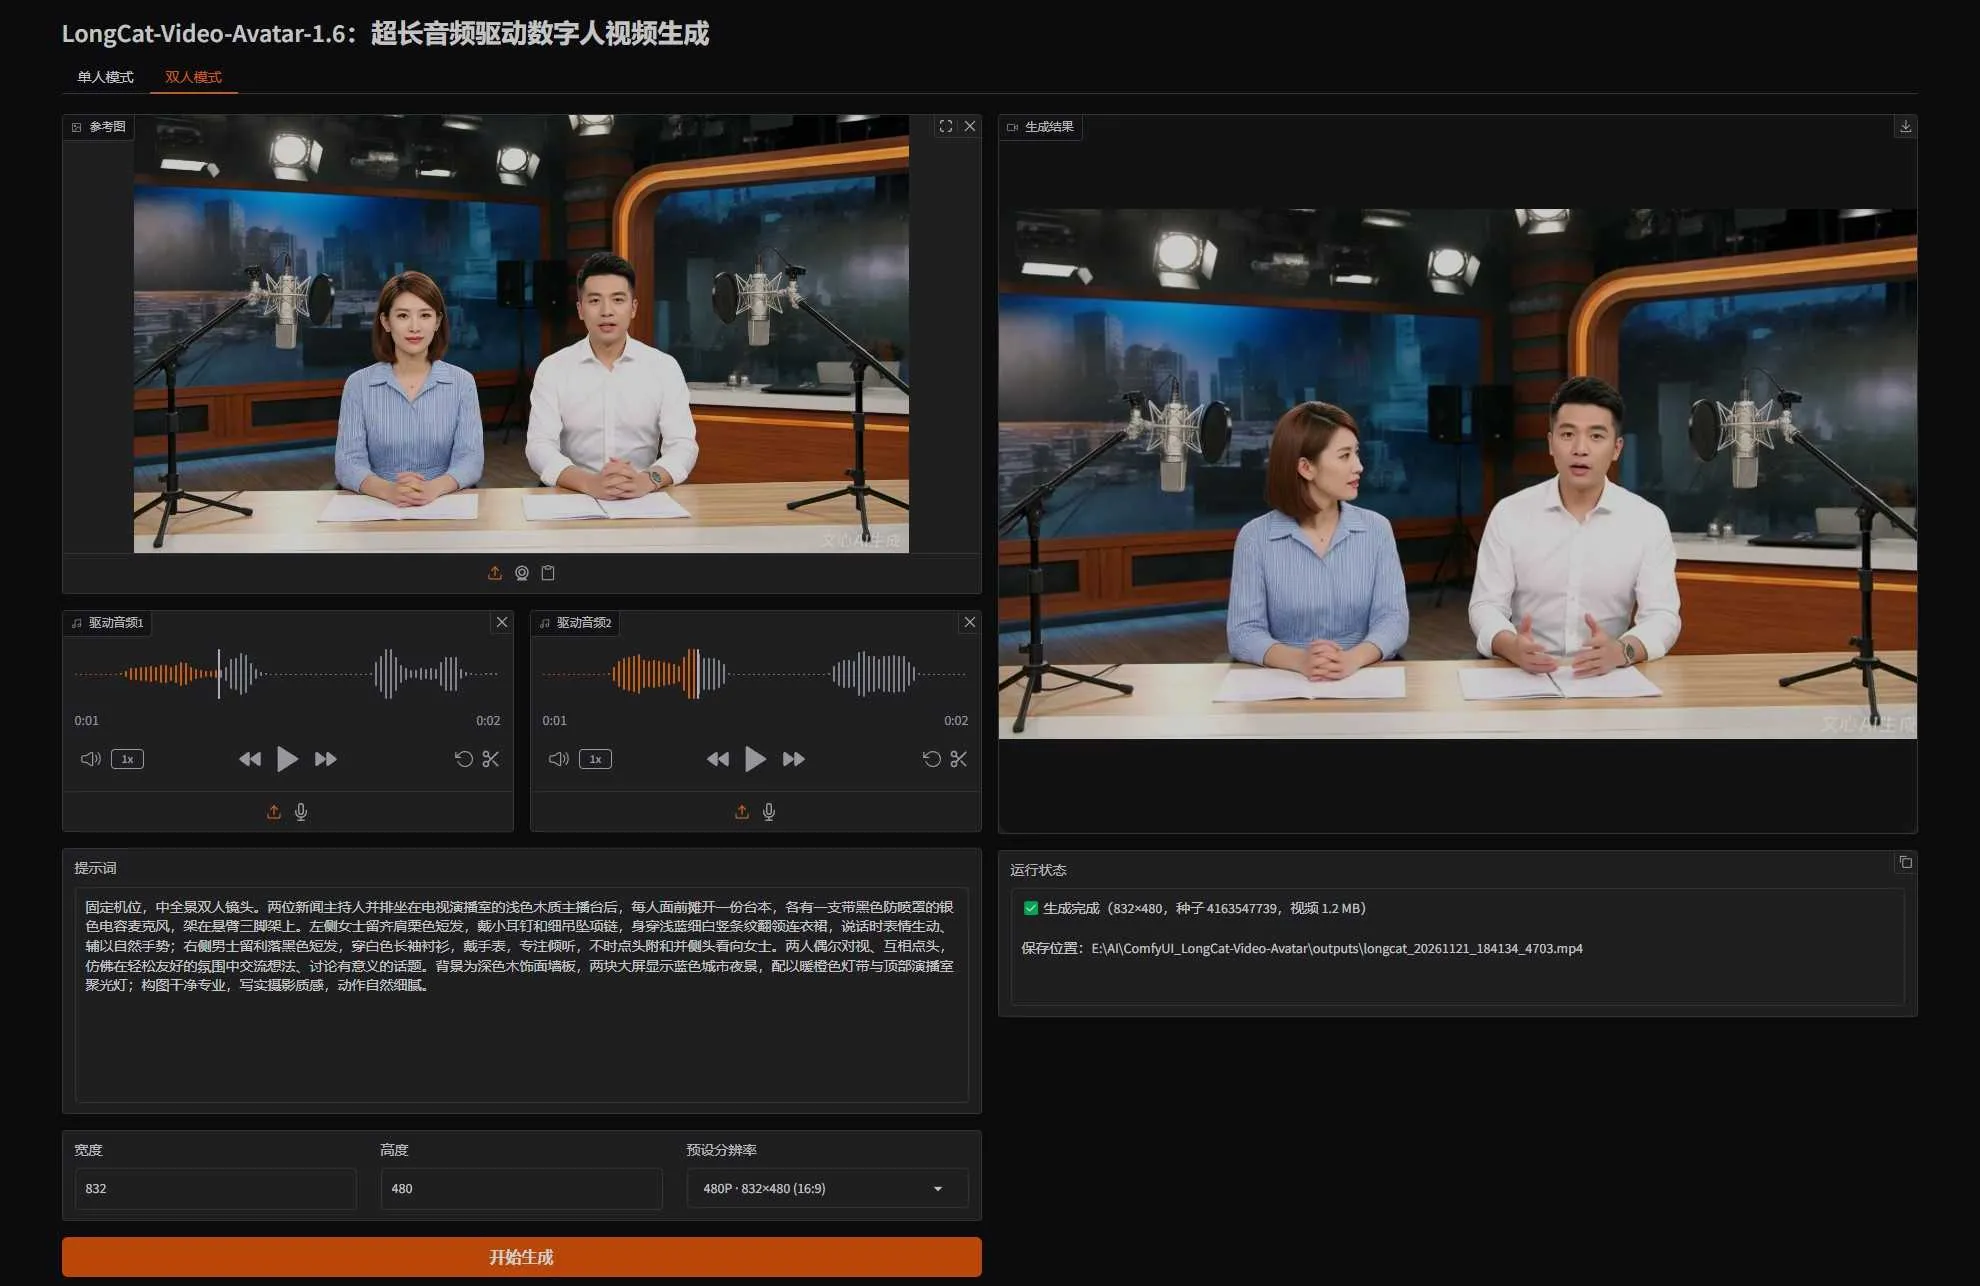
支持单人和双人两种模式,双人模式需要上传一张两人照
ComfyUI工作流
双击启动,浏览器打开 http://localhost:8188,点击左侧的 工作流程,选择对应的工作流
进入工作流后,上传参考图和驱动音频,输入提示词,设置宽度和高度,最后生成即可。
支持单人和双人两种模式,选择对应的工作流,双人模式需要上传一张两人照片
说下优缺点:优点是相比上一代1.5,能生成更长的视频,最高支持10分钟以上的视频生成,而且生成的效果也更好。缺点是速度很慢,非常慢,尤其是8G显存,建议12G显存起,运存32G起。
软件目录结构:
📂 ComfyUI/
├── 📂 models/
│ ├── 📂 diffusion_models/
│ │ └── longcat-avatar-1.6_int8_convrot.safetensors
│ ├── 📂 text_encoders/
│ │ └── umt5_xxl_int8_convrot.safetensors
│ ├── 📂 loras/
│ │ └── longcat-avatar-1.6_dmd_lora_rank128_bf16.safetensors
│ │ └── longcat-avatar-1.6_opsd_lora_rank128_bf16.safetensors
│ ├── 📂 vae/
│ │ └── wan_2.1_vae.safetensors
│ ├── 📂 audio_encoders/
│ │ └── whisper_large_v3_encoder_fp16.safetensors
📂 deepface/
......
下载地址:
光鸭云盘:https://www.guangyapan.com/s/1971253396453789752_afKpfuS_zVounNhq
夸克网盘:
百度网盘:
| 


 发表于